Derniers Articles
Trafic Google en baisse : Reddit va tester la connexion obligatoire pour accéder au site HubSpot perd 80 % de son trafic SEO : son CMO explique ce que l’entreprise mesure désormais à la place Google accusé de voler le trafic des sites web : la riposte est lancée ! IBOU : le moteur français s’ouvre au grand public avant l’arrivée de sa version conversationnelle Connected Apps Platform : Google ouvre Search et l’app Gemini aux développeurs via MCP ChatGPT Shopping : pourquoi un e-commerçant n’est pas classé de la même façon aux États-Unis et en Europe Google ne lit pas vos PDF, il les convertit en HTML Comment Google Discover décide que vos contenus sont périmés : le « SDF freshness » « Économisez votre énergie » : quand Google traite la fraîcheur des données de la Search Console avec (trop) de légèreté Spam UGC : Google cible désormais les outils qui génèrent des pages, des contenus et des web appsLire l'article complet : Dell, Investopedia, franceinfo : ces sites dont les données structurées se sont cassées le 20 août sans déclencher d’alerte
Publié le 16/09/2026 à 12:01:37 par Neper
Dell, Investopedia, franceinfo : ces sites dont les données structurées se sont cassées le 20 août sans déclencher d’alerte
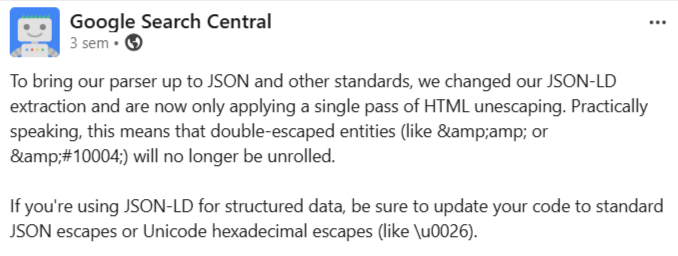
Le 20 août 2026, le compte LinkedIn de Google Search Central a annoncé un changement dans l’extraction du JSON-LD (le format de données structurées recommandé par Google, inséré dans un bloc script au sein du HTML) : le parseur n’applique plus qu’une seule passe de déséchappement HTML, là où il en enchaînait plusieurs. Les entités doublement échappées, du type & pour un simple &, ne sont plus corrigées.
Le point qui doit vous alerter n’est pas le changement lui-même : c’est que cette panne ne déclenche aucun signal.
Le JSON reste syntaxiquement valide, la Search Console ne remonte aucune erreur, le test des résultats enrichis affiche un verdict positif. Seule la valeur stockée par Google change, et elle change silencieusement.
Sur la page d’accueil de dell.com, la description extraite par l’outil de validation de Google contient aujourd’hui la chaîne littérale « services & support » à la place de l’esperluette attendue.
Un recensement publié fin août sur le Tranco top 10 000 chiffre l’ampleur réelle : 10 domaines sont affectés par le changement, mais 199 domaines publient des valeurs que Googlebot lit différemment de tout autre parseur, avant comme après.
L’audit à mener ne consiste donc pas à valider votre balisage. Il consiste à vérifier ce que Google en extrait.
Une seule passe de déséchappement : ce que Google a changé le 20 août
L’annonce tient en un paragraphe, publié sur LinkedIn et nulle part ailleurs : pour aligner son parseur sur JSON et les autres standards, Google n’applique plus que « a single pass of HTML unescaping ». Concrètement, une entité doublement échappée comme & ou ✔ n’est plus résolue en cascade jusqu’au caractère final. Google recommande de passer aux échappements JSON standard ou aux échappements Unicode hexadécimaux comme \u0026.
Gary Illyes, analyste chez Google, a complété en commentaire : l’échappement correct en JSON est « very, very well defined in RFC 8259 », section 7. Cette RFC 8259 (la spécification du format JSON) définit une liste fermée de séquences d’échappement par barre oblique inverse, à laquelle les entités HTML n’ont jamais appartenu.
Ryan Levering, ingénieur logiciel chez Google, a livré dans le même fil la justification technique absente de l’annonce : le double échappement est « relativement rare dans la vraie vie », ressemble généralement à un bug, et le double déséchappement causait des problèmes, en interne comme pour la parité avec les interprétations externes.
Dernier élément de contexte, vérifié le 2 septembre 2026 : le changelog officiel de la documentation Search Central, dont la dernière entrée date du 31 août, ne mentionne pas ce changement. Une modification du comportement d’extraction, annoncée uniquement par un post social, sans trace dans la documentation.
Un JSON valide, des valeurs corrompues : la panne que rien ne signale
Le mécanisme de la panne mérite d’être décomposé, parce qu’il explique pourquoi votre outillage ne la verra pas.
Quand un bloc script type="application/ld+json" contient &, deux systèmes d’échappement se superposent : l’encodage d’entités HTML (la représentation d’un caractère par une séquence comme &) et l’échappement de chaînes JSON. Jusqu’en août, le parseur de Google déroulait les entités jusqu’à obtenir un caractère simple. Il s’arrête désormais après une passe : & devient &, chaîne littérale, et s’arrête là.
Rien n’échoue...