Derniers Articles
Trafic Google en baisse : Reddit va tester la connexion obligatoire pour accéder au site HubSpot perd 80 % de son trafic SEO : son CMO explique ce que l’entreprise mesure désormais à la place Google accusé de voler le trafic des sites web : la riposte est lancée ! IBOU : le moteur français s’ouvre au grand public avant l’arrivée de sa version conversationnelle Connected Apps Platform : Google ouvre Search et l’app Gemini aux développeurs via MCP ChatGPT Shopping : pourquoi un e-commerçant n’est pas classé de la même façon aux États-Unis et en Europe Google ne lit pas vos PDF, il les convertit en HTML Comment Google Discover décide que vos contenus sont périmés : le « SDF freshness » « Économisez votre énergie » : quand Google traite la fraîcheur des données de la Search Console avec (trop) de légèreté Spam UGC : Google cible désormais les outils qui génèrent des pages, des contenus et des web appsLire l'article complet : Cloudflare a menacé le trafic de ses propres clients pour faire plier Google, et il a obtenu un accord
Publié le 16/09/2026 à 10:24:40 par Neper
Cloudflare a menacé le trafic de ses propres clients pour faire plier Google, et il a obtenu un accord
Le 1er juillet 2026, Cloudflare a posé un ultimatum : au 15 septembre, tout site qui avait choisi de cocher le paramètre de rejet des bots destinés à la collecte des données d’entraînement des modèles verrait aussi Googlebot, Bingbot et Applebot coupés.
Pourquoi ces bots ? Parce que leurs propriétaires font exprès de ne pas faire de différence entre le bot qui sert à l’exploration et l’indexation des sites pour le Search, et pour collecter des données d’entrainement des modèles. D’autres acteurs ont des bots différents, reconnaissable par des user agents différents. Mais pas Google, Bing, et Apple.
Du coup, cette décision pouvait ruiner le référencement des sites concernés, de manière silencieuse (qui lis les mails de Cloudflare chez vous ? Et qui aurait identifié immédiatement Cloudflare comme le responsable de l’arrêt de l’indexation ?).
Il faut insister dans quelle direction Cloudflare pointait son arme. Pas sur Google, qui perd peu à ne pas explorer quelques milliers de sites. Mais sur le trafic organique des clients de Cloudflare, pris en otage pour obtenir d’un tiers qu’il sépare ses robots.
Le 15 septembre, Cloudflare n’a pas mis sa menace à exécution : ils ont annoncé avoir signé des accords.
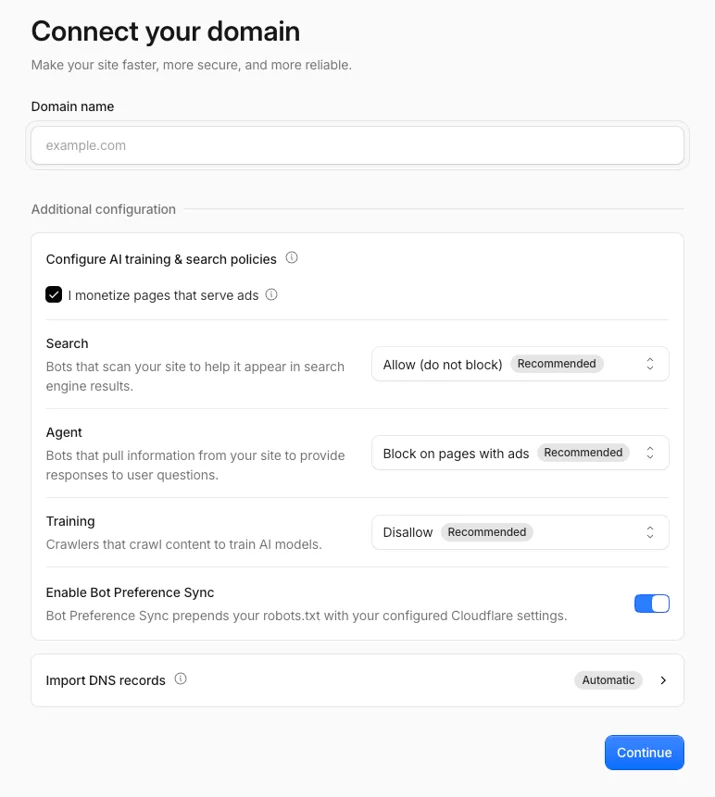
Google, Apple et Microsoft n’ont séparé aucun crawler, ni le 15 ni depuis. Ils ont signé des engagements écrits auprès de Cloudflare, obtenu un label maison baptisé Accountable, et l’ultimatum a été remplacé par un nouveau réglage, Disallow AI Training, qui laisse passer la recherche.
Tout ça pour ça !
Ce qui se jouait, et pourquoi personne ne pouvait en sortir gagnant
Le web a longtemps fonctionné sur un échange tacite : vous laissez entrer un robot, il vous renvoie des visiteurs. L’IA a cassé l’équilibre des termes de l’échange. La même requête qui indexe votre page nourrit un modèle qui répondra à votre place.
La difficulté tient à un détail d’architecture. Google, Apple et Microsoft explorent avec un robot à usages multiples : un seul agent, une seule requête, deux finalités. Refuser l’une revenait à refuser l’autre. Les chiffres publiés par Cloudflare disent l’ampleur du piège : moins de 1 % des sites de son réseau bloquent les robots de recherche, contre 17 % qui activent un blocage de l’entraînement. Autrement dit, un site sur six exprimait un refus qu’il ne pouvait pas appliquer sans sacrifier son référencement.
Cloudflare a passé un an à réclamer la séparation des crawlers. Il l’a demandée par exemple à la CMA britannique en février 2026, par écrit. La CMA a refusé en juin, jugeant la mesure disproportionnée.
Restait un levier : puisque les régulateurs n’allaient pas imposer la séparation à Google, Cloudflare allait rendre le statu quo insupportable pour les contrevenants en coupant le robinet chez les éditeurs.
La méthode était brutale, et le calendrier de dix semaines servait explicitement à laisser un délai pour négocier.
Ce que les éditeurs gagnent vraiment dans l’histoire
Un seul petit réglage dans Cloudflare permet désormais de rester exploré pour la recherche tout en refusant l’entraînement.
C’est beaucoup mieux que ce permet aujourd’hui un disallow dans un robots.txt, puisque bloquer Googlebot c’était tuer son référencement.
Cela fonctionne aujourd’hui sur Google et sur Apple, qui appliquent déjà des jetons d’exclusion respectés et confirment publiquement que ce refus n’affecte pas le classement.
Le second gain est une batterie d’engagements de la part des moteurs des recherches, dont certains sont nouveaux et clairement bienvenus.
Les quatre conditions du label Accountable exigent :
- un mécanisme d’exclusion de l’entraînement,
- un...