Derniers Articles
Google Discover : une offre d’emploi dévoile un projet d’assistant IA hyper-personnalisé Backlink en .gouv.fr : la petite astuce SEO qui ne marche plus depuis le 5 octobre Programme UGC Fresh Data : Google invite les plateformes à lui envoyer leurs contenus en quasi temps réel AI Overviews : la grande dégringolade des sites d’infos Sources préférées : la Search Console révèle combien d’internautes ont choisi votre site OpenAI va ajouter un filigrane invisible textGrain aux textes de ChatGPT en Europe Le Chonk : Mistral dévoile Large 4, un modèle ouvert à 1 000 milliards de paramètres Une prochaine mise à jour massive chez Google ? Les signes annonciateurs « Un signal de page de faible qualité » : Google met en garde contre les faux profils d’auteurs « Jusqu’à un an » : Gary Illyes dévoile les délais de crawl, d’indexation et de récupération chez GoogleLire l'article complet : JavaScript et SEO, crawl d’un site JS
Publié le 06/06/2023 à 05:35:04 par Neper
JavaScript et SEO, crawl d’un site JS
Il est assez facile de déterminer si un site web a été élaboré à partir d’un framework JavaScript. En revanche, repérer les pages, les sections ou les entités et balises HTML qui sont modifiées dynamiquement via JavaScript s’avère plus complexe. Pour cela, un crawl spécifique est nécessaire. Dans la continuité de notre article sur le JavaScript et SEO, je vous propose de voir comment un crawl avec rendu du JavaScript peut être fait à l’aide de Screaming Frog.
Crawler un site JavaScript avec Screaming Frog
Le mode de rendu d’un crawl par défaut de Screaming Frog est « Text only » (texte uniquement). Dans ce mode, le crawl d’un site CSR (voir notre article), donne des résultats très limités.
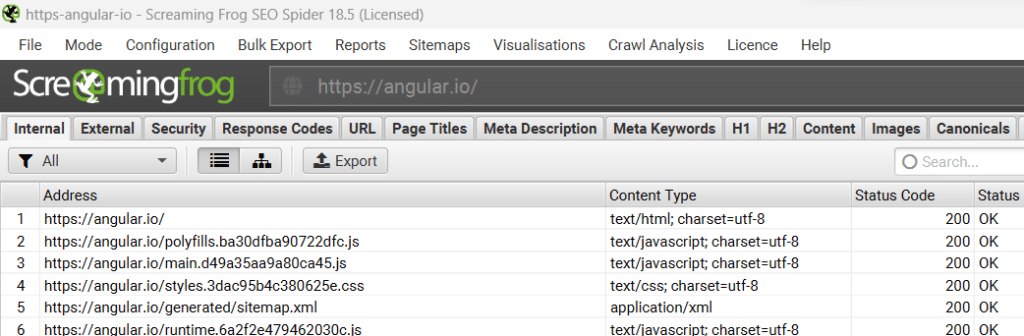
Dans l’illustration ci-dessous, on remarque très vite que suite au crawl de la page d’accueil, nous n’avons pas d’autres pages HTML, mais directement des ressources CSS et JS et le sitemap.
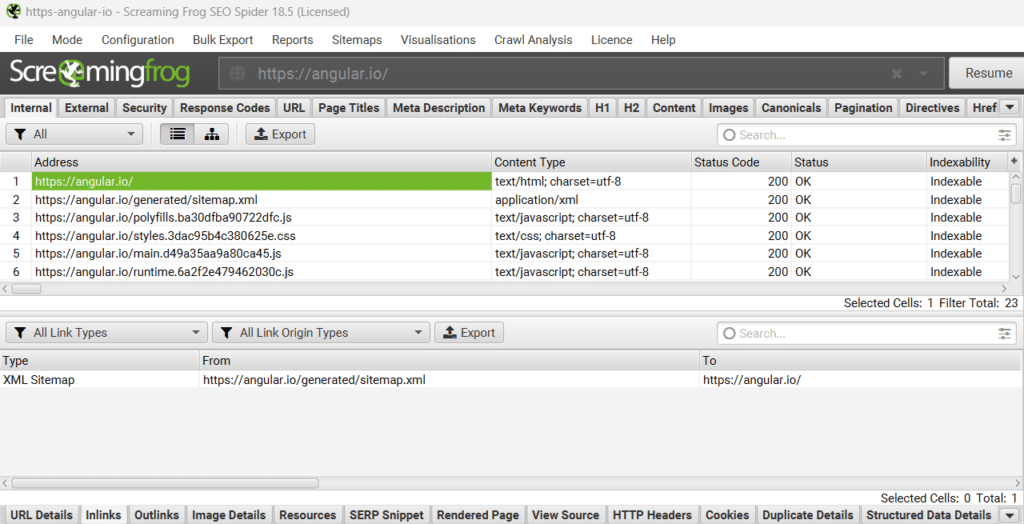
Nous savons tous que les liens internes et les liens de navigations sont essentiels pour que les moteurs de recherche puissent découvrir les différentes pages qui composent un site Web. Mais aussi pour avoir un bon aperçu de la structure du site entre autres.
En examinant les liens internes entrants (inlinks) de la page d’accueil de notre site exemple : angular.io, on remarque que celle-ci ne reçoit qu’un seul lien entrant : en provenance du sitemap. Est-ce que cela signifie que les différentes pages du site ne font pas de lien remontant vers la page d’accueil ? Nous y répondrons un peu plus loin dans notre article.
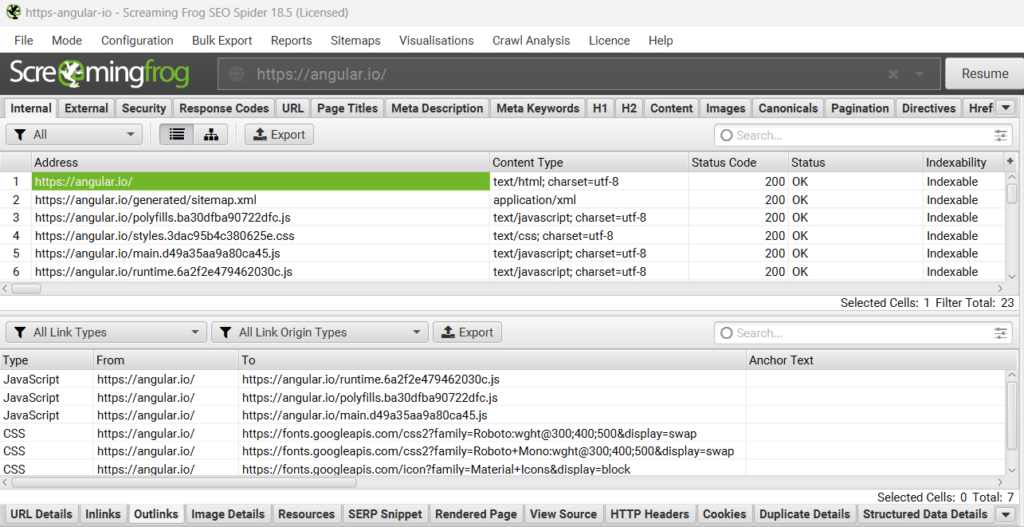
De la même manière, on remarque que la page d’accueil fait des liens internes sortants (outlinks) que vers des ressources JS et CSS, aucun lien HTML avec une ancre cliquable !