Derniers Articles
Trafic Google en baisse : Reddit va tester la connexion obligatoire pour accéder au site HubSpot perd 80 % de son trafic SEO : son CMO explique ce que l’entreprise mesure désormais à la place Google accusé de voler le trafic des sites web : la riposte est lancée ! IBOU : le moteur français s’ouvre au grand public avant l’arrivée de sa version conversationnelle Connected Apps Platform : Google ouvre Search et l’app Gemini aux développeurs via MCP ChatGPT Shopping : pourquoi un e-commerçant n’est pas classé de la même façon aux États-Unis et en Europe Google ne lit pas vos PDF, il les convertit en HTML Comment Google Discover décide que vos contenus sont périmés : le « SDF freshness » « Économisez votre énergie » : quand Google traite la fraîcheur des données de la Search Console avec (trop) de légèreté Spam UGC : Google cible désormais les outils qui génèrent des pages, des contenus et des web appsLire l'article complet : Une offre d’emploi de Google confirme ce qu’on observe dans Discover
Publié le 20/08/2026 à 11:58:26 par Abondance
Une offre d’emploi de Google confirme ce qu’on observe dans Discover
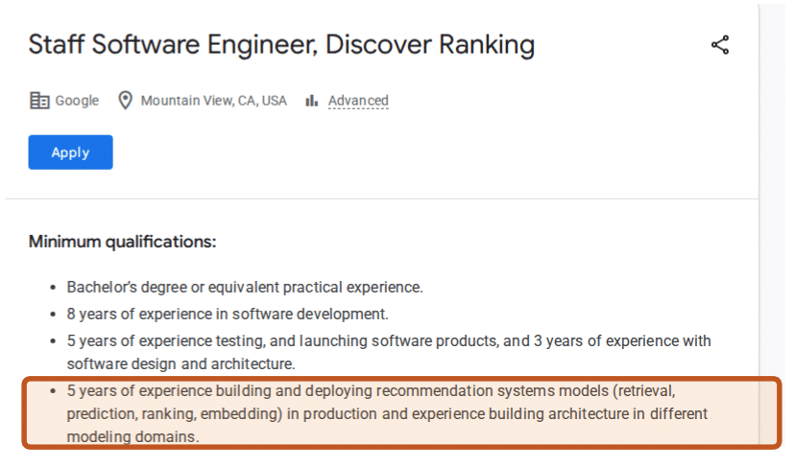
L’offre « Staff Software Engineer, Discover Ranking » sur Google Careers. La quatrième ligne des prérequis nomme les briques du système. Surlignage ajouté par nos soins.
Quatre mots techniques, qui décrivent la chaîne complète d’un système de recommandation : sélectionner des contenus candidats, prédire ce que chaque lecteur va en faire, les classer, et représenter lecteurs et contenus sous une forme que la machine sait comparer.
Une offre d’emploi décrit des compétences recherchées, rien de plus. Sa valeur vient du recoupement : chez 1492.vision, nous observons de vrais flux Discover depuis deux ans, et ces mots recoupent très exactement ce que nous voyons passer. Voici trois exemples concrets, racontés simplement ; l’analyse complète, chiffres et graphiques à l’appui, est dans notre étude de référence (disponible en français et en anglais).
Chaque carte de votre flux porte des prédictions
Commençons par le mot « prediction ». Chaque carte qui s’affiche dans un flux Discover a été évaluée par des modèles qui prédisent le comportement du lecteur : va-t-il s’arrêter dessus ? Cliquer ? Lire en profondeur ?
Ces prédictions laissent des traces bien concrètes : des scores, que nous observons sur les cartes de nos panels de test. Et elles se résument à deux questions étonnamment indépendantes :
- Cette carte va-t-elle arrêter l’œil ? C’est une propriété de l’article : son titre, son image. Elle varie peu d’un lecteur à l’autre.
- Ce lecteur précis va-t-il s’engager ? Cliquer, lire longtemps, interagir. Celle-ci dépend énormément de chaque lecteur.
Les deux peuvent diverger complètement, et c’est toute la définition du clickbait : un titre qui arrête l’œil de tout le monde et ne retient personne. À l’inverse, un contenu de niche peut engager profondément ses lecteurs sans jamais accrocher la majorité.
Dans nos mesures, ces prédictions collent au comportement réel observé ensuite sur le panel : quand le score d’engagement prédit est haut, l’interaction constatée est environ deux fois plus forte que quand il est bas.
L’affinité change tout, à contenu égal
La personnalisation se raconte en deux exemples.
Premier exemple. Sur nos comptes de test, nous avons comparé deux éditeurs de sport, sur la même thématique, face aux mêmes comptes. Le potentiel de leurs sujets, tel que le système lui-même l’évalue, était du même ordre. Résultat : pour l’un des deux, les prédictions d’engagement étaient environ 2 fois plus élevées, et la visibilité finale dans les flux environ 8 fois plus forte, à sujet comparable.
Le détail qui...