Derniers Articles
API ibou : le moteur de recherche français ouvre son index pour 1 € les 1 000 unités Piloter son SEO depuis son IA : Sedestral connecte ses agents à Claude et ChatGPT grâce au MCP Trafic Google en baisse : Reddit va tester la connexion obligatoire pour accéder au site HubSpot perd 80 % de son trafic SEO : son CMO explique ce que l’entreprise mesure désormais à la place Google accusé de voler le trafic des sites web : la riposte est lancée ! IBOU : le moteur français s’ouvre au grand public avant l’arrivée de sa version conversationnelle Connected Apps Platform : Google ouvre Search et l’app Gemini aux développeurs via MCP ChatGPT Shopping : pourquoi un e-commerçant n’est pas classé de la même façon aux États-Unis et en Europe Google ne lit pas vos PDF, il les convertit en HTML Comment Google Discover décide que vos contenus sont périmés : le « SDF freshness »Lire l'article complet : Google Discover sous le capot : 20 pipelines, des millions de cartes, des insights inédits issus de la data.
Publié le 30/03/2026 à 14:09:38 par Abondance
Google Discover sous le capot : 20 pipelines, des millions de cartes, des insights inédits issus de la data.
L'analyse SDK de Metehan Yesilyurt a révélé les noms des pipelines internes de Google Discover. Nos données montrent ce que chacun fait réellement : volume, portée, timing, domaines leaders. 42 millions de cartes, des centaines d'appareils, trois mois d'observation.
Ce qu'on a fait
Pendant trois mois (décembre 2025 - février 2026), nous avons observé les flux Discover réels de centaines d'appareils. Résultat : 42 millions de cartes analysées. A chaque carte nous avons associé le pipeline responsable de sa sélection.
Les noms existaient déjà dans le SDK Google, ils ont notamment été publiés récemment par Metehan Yesilyurt. Ce qui manquait, c'est ce qu'ils font en pratique : combien de contenu chacun sélectionne, à combien d'appareils il le montre, à quelle vitesse, et quels domaines il privilégie. C'est ce que nos données révèlent.
Pour chaque pipeline, nous calculons quatre métriques :
- La portée : pourcentage d'appareils qui voient chaque URL par jour
- La vitesse : âge médian des articles au moment de leur apparition
- L'exclusivité : pourcentage d'URLs propres au pipeline
- Le volume : part dans le flux total
La révélation : pas un algorithme, un système à couches
La croyance courante : Discover utilise un algorithme de recommandation. La réalité : c'est un système structuré en six couches fonctionnelles, chacune avec une logique et une audience distinctes.
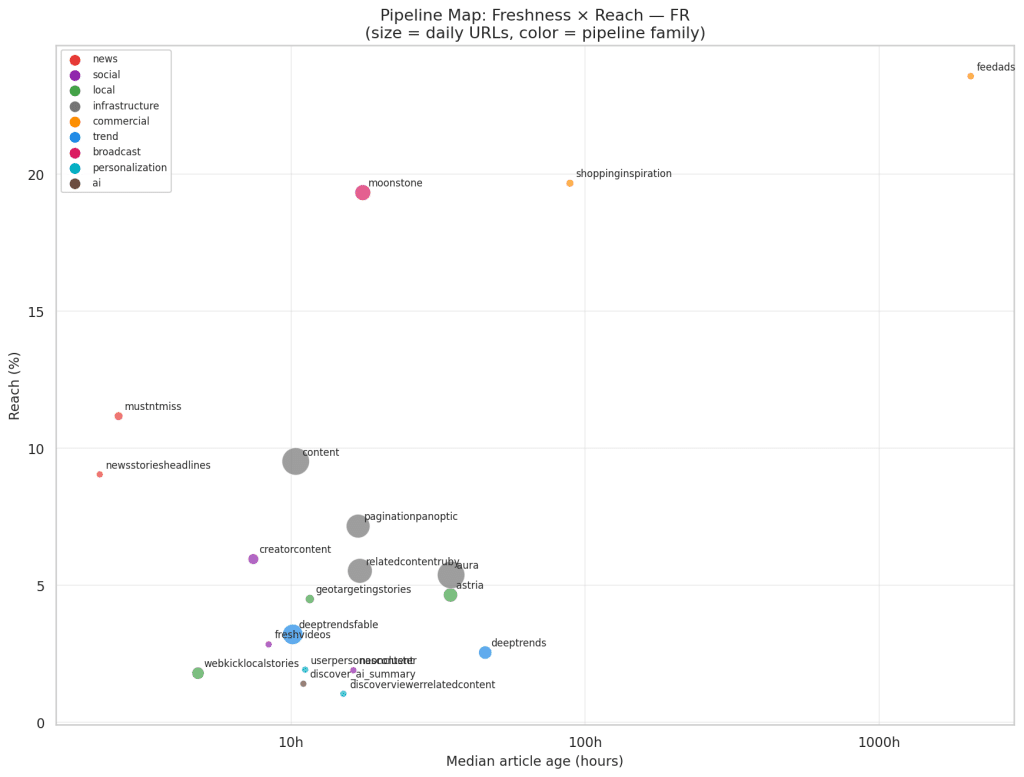
Chaque pipeline positionné par sa vitesse (axe X, log) et sa portée (axe Y). Couleur = famille fonctionnelle. moonstone et shoppinginspiration dominent en portée ; mustntmiss et newsstoriesheadlines sont les plus rapides ; deeptrends et aura persistent le plus longtemps.
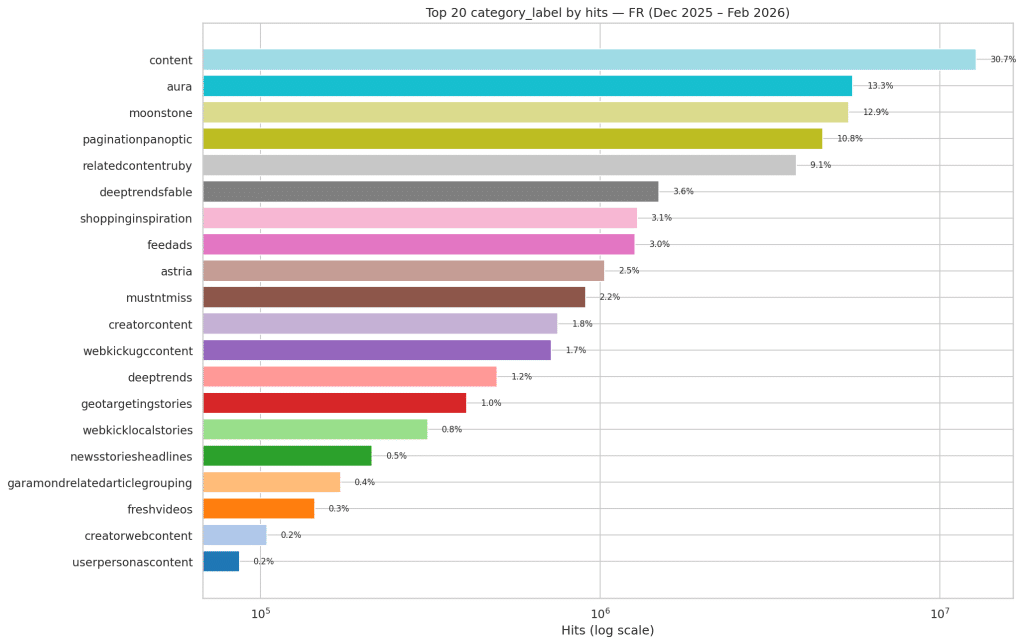
Les 20 pipelines FR classés par volume total. content domine à 30,7 %, suivi d'aura (13,3 %) et moonstone (12,9 %).